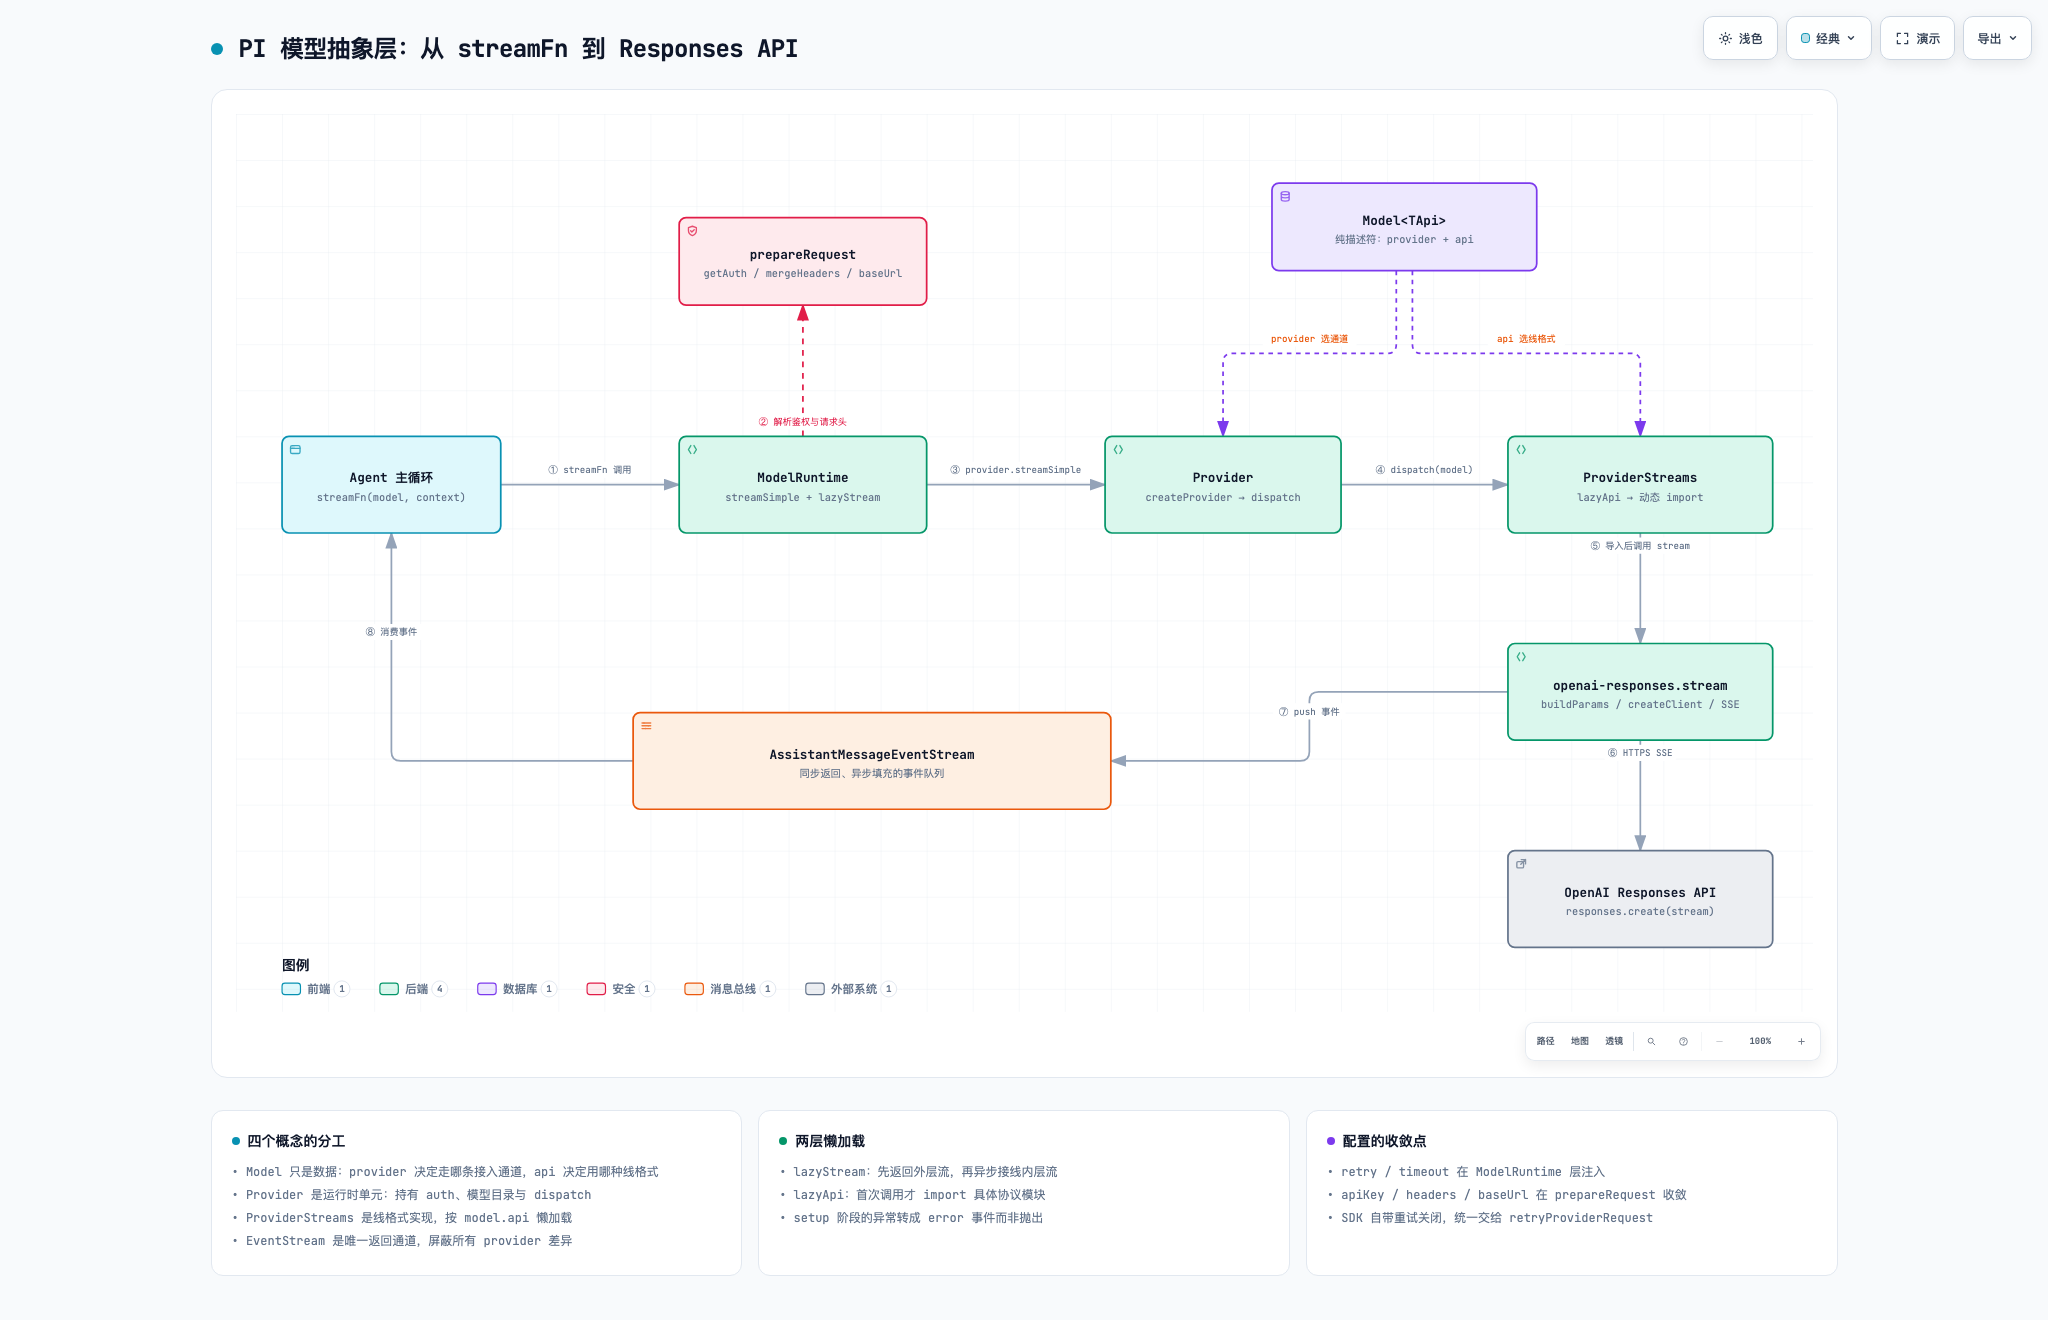
PI分析-模型抽象层

写 agent 内核那篇的时候,我留了个黑盒没拆:主循环把对话内容交给一个叫 streamFn 的函数,它吐回一串事件,中间发生了什么完全没管。

我们顺着这条线往下拆一拆

StreamFn

1
2
3
4
5
export type StreamFn = (
model: Model<Api>,
context: Context,
options?: SimpleStreamOptions,
) => AssistantMessageEventStream | Promise<AssistantMessageEventStream>;

model是什么?

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
// Model interface for the unified model system
export interface Model<TApi extends Api> {
id: string;
name: string;
api: TApi; // wire format
provider: ProviderId; // 接入通道,比如 openai,bedrock,hunyuan
baseUrl: string;
reasoning: boolean;
/**
* Maps pi thinking levels to provider/model-specific values.
* Missing keys use provider defaults. null marks a level as unsupported.
*/
thinkingLevelMap?: ThinkingLevelMap;
input: ("text" | "image")[];
cost: ModelCost;
contextWindow: number;
maxTokens: number; // output 最多多少个token
/** Default sampling parameters for this model. See {@link StreamOptions.samplingParams}; per-request keys override these. */
samplingParams?: Record<string, unknown>;
headers?: Record<string, string>;
/** Compatibility overrides for OpenAI-compatible APIs. If not set, auto-detected from baseUrl. */
compat?: TApi extends "openai-completions"
? OpenAICompletionsCompat
: TApi extends "openai-responses" | "azure-openai-responses" | "openai-codex-responses"
? OpenAIResponsesCompat
: TApi extends "anthropic-messages"
? AnthropicMessagesCompat
: TApi extends "bedrock-converse-stream"
? BedrockCompat
: never;
}

// 可以看看一般赋值是啥
const model: Model<"openai-responses"> = {
id: "gpt-5.4",
name: "GPT-5.4",
api: "openai-responses",
provider: "openai",
baseUrl: "https://api.openai.com/v1",
reasoning: true,
input: ["text"],
cost: { input: 0, output: 0, cacheRead: 0, cacheWrite: 0 },
contextWindow: 400000,
maxTokens: 128000,
};

所以就是provider决定走什么接入通道,一个接入通道可以实现多种api格式,然后通过id,name去选择模型

streamFn的具体实现

这个我们需要沿着链条追踪一下

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
// 创建AgentSessionRuntime的时候,传入了streamFn, 都是在解析一些配置啥的
//仔细看看最后的streamSimple即可
streamFn: async (model, context, options) => {
const providerRetrySettings = settingsManager.getProviderRetrySettings();
const httpIdleTimeoutMs = settingsManager.getHttpIdleTimeoutMs();
// SDKs treat timeout=0 as 0ms (immediate timeout), not "no timeout".
// Use max int32 to effectively disable the timeout.
const effectiveTimeoutMs = httpIdleTimeoutMs === 0 ? 2147483647 : httpIdleTimeoutMs;
const timeoutMs = options?.timeoutMs ?? providerRetrySettings.timeoutMs ?? effectiveTimeoutMs;
const websocketConnectTimeoutMs =
options?.websocketConnectTimeoutMs ?? settingsManager.getWebSocketConnectTimeoutMs();
const headerRunner = extensionRunnerRef.current;
return modelRuntime.streamSimple(model, context, {
...options,
timeoutMs,
websocketConnectTimeoutMs,
maxRetries: options?.maxRetries ?? providerRetrySettings.maxRetries,
maxRetryDelayMs: options?.maxRetryDelayMs ?? providerRetrySettings.maxRetryDelayMs,
transformHeaders: async (requestHeaders) => {
const headers = mergeProviderAttributionHeaders(
model,
settingsManager,
options?.sessionId,
requestHeaders,
);
return headerRunner?.hasHandlers("before_provider_headers")
? headerRunner.emitBeforeProviderHeaders(headers ?? {})
: (headers ?? {});
},
});
},

// 这里获取到provider后会调用provider的streamSimple
streamSimple(model: Model<Api>, context: Context, options?: ModelsSimpleStreamOptions): AssistantMessageEventStream {
return lazyStream(model, async () => {
const prepared = await this.prepareRequest(model, options);
return prepared.provider.streamSimple(prepared.model, context, prepared.options as SimpleStreamOptions);
});
}

private async prepareRequest<TOptions extends ProviderRequestOptions & ModelsRequestTransforms>(
model: Model<Api>,
options: TOptions | undefined,
): Promise<{
provider: Provider;
model: Model<Api>;
options: Omit<TOptions, "transformHeaders"> & ProviderRequestOptions;
}> {
const provider = this.models.getProvider(model.provider);
if (!provider) throw new ModelsError("provider", `Unknown provider: ${model.provider}`);
const resolution = await this.getAuth(model, {
apiKey: options?.apiKey,
env: options?.env,
signal: options?.signal,
});
if (!resolution) throw new ModelsError("auth", `Provider is not configured: ${model.provider}`);

const { transformHeaders, ...rawProviderOptions } = options ?? {};
const providerOptions = rawProviderOptions as Omit<TOptions, "transformHeaders"> & ProviderRequestOptions;
let headers = mergeHeaders(resolution.auth.headers, providerOptions.headers);
if (transformHeaders) headers = await transformHeaders(headers ?? {});
const env =
resolution.env || providerOptions.env
? { ...(resolution.env ?? {}), ...(providerOptions.env ?? {}) }
: undefined;
return {
provider,
model: resolution.auth.baseUrl ? { ...model, baseUrl: resolution.auth.baseUrl } : model,
options: {
...providerOptions,
apiKey: providerOptions.apiKey ?? resolution.auth.apiKey,
headers,
env,
} as Omit<TOptions, "transformHeaders"> & ProviderRequestOptions,
};
}

也就是会调用provider的streamSimple,继续往下看看

provider

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
/**
* A provider is the concrete runtime unit. It owns id/name/base metadata,
* auth methods, model listing, and stream behavior.
*
* `TApi` lets concrete provider factories declare which APIs their models
* use (e.g. `openaiProvider(): Provider<"openai-responses" | "openai-completions">`),
* giving typed model lists to direct factory users. Inside a `Models`
* collection providers are held as `Provider<Api>`.
*/
export interface Provider<TApi extends Api = Api> {
readonly id: string;
readonly name: string;

readonly baseUrl?: string;
readonly headers?: ProviderHeaders;

/**
* Required: at least one of `apiKey`/`oauth`. Every provider has auth
* semantics — even providers with only ambient credentials (env vars, AWS
* profiles, ADC files) and keyless local servers provide `apiKey` auth
* whose `resolve()` reports whether the provider is configured.
* `Models.getAuth()` returns undefined when the provider is unconfigured.
*/
readonly auth: ProviderAuth;

/**
* Current known models, sync. Static providers return their catalog;
* dynamic providers return the list as of the last `refreshModels()`
* (empty before the first). Must not throw; `Models` treats a throwing
* implementation as having no models.
*/
getModels(): readonly Model<TApi>[];

/**
* Dynamic providers only: restore `context.stored` and optionally fetch a newer list using
* the effective credential. Implementations retain their previous list on failure, publish
* persistence and synchronous state changes through `context.publish()`, and honor the
* shared abort signal for blocking work.
*/
refreshModels?(context: RefreshModelsContext): Promise<void>;

/**
* Optional provider policy for credential-specific model availability.
* `getModels()` remains the complete synchronous catalog; `Models.getAvailable()`
* applies this filter after confirming that provider auth is configured.
*/
filterModels?(models: readonly Model<TApi>[], credential: Credential | undefined): readonly Model<TApi>[];

stream<T extends TApi>(
model: Model<T>,
context: Context,
options?: ApiStreamOptions<T>,
): AssistantMessageEventStream;

streamSimple(model: Model<TApi>, context: Context, options?: SimpleStreamOptions): AssistantMessageEventStream;
fetchDeferred?(
model: Model<TApi>,
handle: DeferredHandle,
options?: DeferredFetchOptions,
): AssistantMessageEventStream;
cancelDeferred?(model: Model<TApi>, handle: DeferredHandle, options?: DeferredCancelOptions): Promise<void>;
}

provider的实现

这里我们就可以看看某个provider的具体实现了, 这个是实现都在packages/ai/src/providers

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
export function openaiProvider(): Provider<"openai-responses"> {
return createProvider({
id: "openai",
name: "OpenAI",
baseUrl: "https://api.openai.com/v1",
auth: { apiKey: envApiKeyAuth("OpenAI API key", ["OPENAI_API_KEY"]) },
models: Object.values(OPENAI_MODELS),
api: openAIResponsesApi(),
});
}

export function createProvider<TApi extends Api = Api>(input: CreateProviderOptions<TApi>): Provider<TApi> {
const baselineModels = input.models;
let dynamicModels: readonly Model<TApi>[] = [];
const fetchModels = input.fetchModels;
// 用于更新当前的model列表
const currentModels = (): readonly Model<TApi>[] => {
const merged = [...baselineModels];
for (const model of dynamicModels) {
const index = merged.findIndex((entry) => entry.id === model.id);
if (index >= 0) merged[index] = model;
else merged.push(model);
}
return merged;
};
// 两种API组织形式,单个API和多个API
const single =
typeof (input.api as ProviderStreams).stream === "function" ? (input.api as ProviderStreams) : undefined;
const byApi = single ? undefined : (input.api as Partial<Record<string, ProviderStreams>>);

const apiFor = (model: Model<Api>): ProviderStreams | undefined => single ?? byApi?.[model.api];

const dispatch = (
model: Model<Api>,
run: (streams: ProviderStreams) => AssistantMessageEventStream,
): AssistantMessageEventStream => {
const streams = apiFor(model);
if (!streams) {
return lazyStream(model, async () => {
throw new ModelsError("stream", `Provider ${input.id} has no API implementation for "${model.api}"`);
});
}
return run(streams);
};

const provider: Provider<TApi> = {
id: input.id,
name: input.name ?? input.id,
baseUrl: input.baseUrl,
headers: input.headers,
auth: input.auth,
getModels: currentModels,
refreshModels: fetchModels, // 这里简化了代码,更加关注核心流程
filterModels: input.filterModels,
stream: (model, context, options) => dispatch(model, (streams) => streams.stream(model, context, options)),
streamSimple: (model, context, options) =>
dispatch(model, (streams) => streams.streamSimple(model, context, options)),
};

return provider;
}

这里核心是传入的CreateProviderOptions.api,最后调用的都是他的streamSimple方法

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
api: openAIResponsesApi(),

export interface ProviderStreams {
// 关注前两个核心方法
stream(model: Model<Api>, context: Context, options?: StreamOptions): AssistantMessageEventStream;
streamSimple(model: Model<Api>, context: Context, options?: SimpleStreamOptions): AssistantMessageEventStream;
fetchDeferred?(
model: Model<Api>,
handle: DeferredHandle,
options?: DeferredFetchOptions,
): AssistantMessageEventStream;
cancelDeferred?(model: Model<Api>, handle: DeferredHandle, options?: DeferredCancelOptions): Promise<void>;
}

// 实现都在packages/ai/src/api,我们此处是以openai为例子
export const openAIResponsesApi = (): ProviderStreams => lazyApi(() => import("./openai-responses.ts"));

export function lazyApi(load: () => Promise<ProviderStreams>, capabilities?: LazyApiCapabilities): ProviderStreams {
const api: ProviderStreams = {
stream: (model, context, options) =>
lazyStream(model, async () => (await load()).stream(model, context, options)),
streamSimple: (model, context, options) =>
lazyStream(model, async () => (await load()).streamSimple(model, context, options)),
};

if (capabilities?.fetchDeferred) {
api.fetchDeferred = (model, handle, options) =>
lazyStream(model, async () => {
const implementation = await load();
if (!implementation.fetchDeferred) throw new Error("API does not support deferred responses");
return implementation.fetchDeferred(model, handle, options);
});
}
if (capabilities?.cancelDeferred) {
api.cancelDeferred = async (model, handle, options) => {
const implementation = await load();
if (!implementation.cancelDeferred) throw new Error("API cannot cancel deferred responses");
await implementation.cancelDeferred(model, handle, options);
};
}

return api;
}

export function lazyStream(
model: Model<Api>,
setup: () => Promise<AsyncIterable<AssistantMessageEvent>>,
): AssistantMessageEventStream {
const outer = new AssistantMessageEventStream();

setup()
.then((inner) => forwardStream(outer, inner)) // inner迭代器的事件推到outer里
.catch((error) => {
// 错误不吞掉而是推到AssistantMessageEventStream里
const message = createSetupErrorMessage(model, error);
outer.push({ type: "error", reason: "error", error: message });
outer.end(message);
});

return outer;
}

async function forwardStream(
target: AssistantMessageEventStream,
source: AsyncIterable<AssistantMessageEvent>,
): Promise<void> {
for await (const event of source) {
target.push(event);
}
target.end(hasResult(source) ? await source.result() : undefined);
}

但其实这里根本使用的import进来的方法
lazyApi(() => import("./openai-responses.ts") 导入的ProviderStreams是什么东西

import(…) 长得像函数调用,但它其实是个语法结构(不是真函数,不能 const f = import 这样引用)。它返回 Promise<模块命名空间对象>:

1
2
await import("./openai-responses.ts")
// → { stream: fn, streamSimple: fn, OpenAIResponsesOptions: ... }

所以接下来需要看的就是具体到api层的streamSimple

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
export const streamSimple: StreamFunction<"openai-responses", SimpleStreamOptions> = (
model: Model<"openai-responses">,
context: Context,
options?: SimpleStreamOptions,
): AssistantMessageEventStream => {
getClientApiKey(model.provider, options?.apiKey, options?.headers);

const base = buildBaseOptions(model, context, options, options?.apiKey);
const clampedReasoning = options?.reasoning ? clampThinkingLevel(model, options.reasoning) : undefined;
const reasoningEffort = clampedReasoning === "off" ? undefined : clampedReasoning;

return stream(model, context, {
...base,
reasoningEffort,
} satisfies OpenAIResponsesOptions);
};

最后调用的也是stream, 这应该算是与llm的最后一层了

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
/**
* Generate function for OpenAI Responses API
*/
export const stream: StreamFunction<"openai-responses", OpenAIResponsesOptions> = (
model: Model<"openai-responses">,
context: Context,
options?: OpenAIResponsesOptions,
): AssistantMessageEventStream => {
const stream = new AssistantMessageEventStream();

// Start async processing
(async () => {
const output: AssistantMessage = {
role: "assistant",
content: [],
api: model.api as Api,
provider: model.provider,
model: model.id,
usage: {
input: 0,
output: 0,
cacheRead: 0,
cacheWrite: 0,
totalTokens: 0,
cost: { input: 0, output: 0, cacheRead: 0, cacheWrite: 0, total: 0 },
},
stopReason: "pending",
timestamp: Date.now(),
};

try {
// Create OpenAI client
const apiKey = getClientApiKey(model.provider, options?.apiKey, options?.headers);
const cacheRetention = resolveCacheRetention(options?.cacheRetention, options?.env);
const cacheSessionId = cacheRetention === "none" ? undefined : options?.sessionId;
const compat = getCompat(model);
const grammarToolInputProperties = createGrammarToolInputProperties(
context.tools,
compat.supportsOpenAIGrammarTools,
);
const client = createClient(model, context, apiKey, options?.headers, options?.fetch, cacheSessionId);
let params = buildParams(model, context, options, compat, grammarToolInputProperties);
const nextParams = await options?.onPayload?.(params, model);
if (nextParams !== undefined) {
params = nextParams as ResponseCreateParamsStreaming;
}
const requestOptions = {
...(options?.signal ? { signal: options.signal } : {}),
...(options?.timeoutMs !== undefined ? { timeout: options.timeoutMs } : {}),
maxRetries: 0,
};
const { data: openaiStream, response } = await retryProviderRequest(
() => client.responses.create(params, requestOptions).withResponse(),
{
maxRetries: options?.maxRetries,
maxRetryDelayMs: options?.maxRetryDelayMs,
signal: options?.signal,
},
);
await options?.onResponse?.({ status: response.status, headers: headersToRecord(response.headers) }, model);
stream.push({ type: "start", partial: output });

await processResponsesStream(openaiStream, output, stream, model, {
serviceTier: options?.serviceTier,
grammarToolInputProperties,
applyServiceTierPricing: (usage, serviceTier) => applyServiceTierPricing(usage, serviceTier, model),
});

if (options?.signal?.aborted) {
throw new Error("Request was aborted");
}

if (output.stopReason === "pending") {
throw new Error("OpenAI Responses stream ended without a stop reason");
}
if (output.stopReason === "aborted" || output.stopReason === "error") {
throw new Error(output.errorMessage || "An unknown error occurred");
}

stream.push({ type: "done", reason: output.stopReason, message: output });
stream.end();
} catch (error) {
for (const block of output.content) {
delete (block as { index?: number }).index;
// Streaming scratch buffers are only used during parsing; never persist them.
delete (block as { partialJson?: string }).partialJson;
delete (block as { customInput?: unknown }).customInput;
}
output.stopReason = options?.signal?.aborted ? "aborted" : "error";
output.errorMessage = formatOpenAIResponsesError(error);
stream.push({ type: "error", reason: output.stopReason, error: output });
stream.end();
}
})();

return stream;
};

这就是具体的协议了,协议的细节很多,这里先不展开,简而言之就是获取到llm的openaiStream往外部返回的stream推消息
不过我们可以稍微看看AssistantMessageEventStream的实现,因为这是整个provider与pi交流的桥梁
整体上是实现了一个同步返回,异步填充的队列

AssistantMessageEventStream

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
export class AssistantMessageEventStream extends EventStream<AssistantMessageEvent, AssistantMessage> {
constructor() {
super(
(event) => event.type === "done" || event.type === "error",
(event) => {
if (event.type === "done") {
return event.message;
} else if (event.type === "error") {
return event.error;
}
throw new Error("Unexpected event type for final result");
},
);
}
}

extend了EventStream

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
interface IteratorYieldResult<TYield> {
done?: false;
value: TYield;
}

interface IteratorReturnResult<TReturn> {
done: true;
value: TReturn;
}

type IteratorResult<T, TReturn = any> = IteratorYieldResult<T> | IteratorReturnResult<TReturn>;


// Generic event stream class for async iteration
export class EventStream<T, R = T> implements AsyncIterable<T> {
private queue: T[] = []; // 事件队列
private waiting: ((value: IteratorResult<T>) => void)[] = []; // 等待队列
private done = false; // 是否完成
private finalResultPromise: Promise<R>; // 最终结果的promise
private resolveFinalResult!: (result: R) => void; // finalResultPromise 的 resolve
private isComplete: (event: T) => boolean; // 外部传入,判断是否完成
private extractResult: (event: T) => R; // 提取结果的函数

constructor(isComplete: (event: T) => boolean, extractResult: (event: T) => R) {
this.isComplete = isComplete;
this.extractResult = extractResult;
this.finalResultPromise = new Promise((resolve) => {
this.resolveFinalResult = resolve;
});
}

push(event: T): void {
if (this.done) return;

if (this.isComplete(event)) {
this.done = true;
this.resolveFinalResult(this.extractResult(event));
}

// Deliver to waiting consumer or queue it
const waiter = this.waiting.shift();
if (waiter) {
waiter({ value: event, done: false }); // done = false, 所以应该是T类型
} else {
this.queue.push(event);
}
}

end(result?: R): void {
this.done = true;
if (result !== undefined) {
this.resolveFinalResult(result);
}
// Notify all waiting consumers that we're done
while (this.waiting.length > 0) {
const waiter = this.waiting.shift()!;
waiter({ value: undefined as any, done: true }); // done = true,返回TReturn(any)类型
}
}

// 迭代获取结果
// 实现了AsyncIterable
async *[Symbol.asyncIterator](): AsyncIterator<T> {
while (true) {
if (this.queue.length > 0) {
// 返回队列中的事件,并等待下一次调用next
yield this.queue.shift()!;
} else if (this.done) {
return;
} else {
// 推入waiting等待push调用
const result = await new Promise<IteratorResult<T>>((resolve) => this.waiting.push(resolve));
if (result.done) return;
yield result.value;
}
}
}

// 直接获取结果
result(): Promise<R> {
return this.finalResultPromise;
}
}

总结

链条追到这里就完整了,回头看一眼全貌

四个概念的关系

概念 是什么 关键字段/方法
Model 纯数据描述符,没有任何行为 provider 决定走哪条接入通道,api 决定用哪种线格式
Provider 运行时单元,一条接入通道 auth / getModels() / stream / streamSimple,内部按 model.api 分发
Api(ProviderStreams) 线格式实现,只管协议不管鉴权 stream / streamSimple,实现都在 packages/ai/src/api
AssistantMessageEventStream 统一返回通道 push / end / result(),屏蔽掉所有 provider 的协议差异

所以这套抽象的分层是很干净的:Model 描述「用什么」,Provider 决定「从哪进」,Api 负责「怎么说」,EventStream 统一「怎么回」。

一个 provider 可以挂多种 api(byApi 分发),一种 api 也能被多个 provider 复用(openai / azure / openrouter 都走 openai-responses),两边靠 Model 上的两个字段撮合。

两个反复出现的套路

一是懒加载,出现了两层。lazyStream 是「同步返回外层流、异步接线内层流」,让整条链上任何一层都不用把 async 泄漏给调用方;lazyApi 则把具体协议模块的 import 推迟到首次调用,不用为了支持一堆 provider 在启动时全量加载。

二是错误不抛,只推事件。lazyStream 的 .catch 把 setup 阶段的异常转成 error 事件,stream 的 try/catch 也是同样处理。整条链上只有一个出错的表达方式,主循环不用同时写 try/catch 和事件处理两套逻辑。


PI分析-模型抽象层
https://silky1313.github.io/2026/09/05/pi-模型抽象层/
作者
silky1313
发布于
2026年9月5日
许可协议